Une ligne dans robots.txt pour refuser l’entraînement des IA : Google, OpenAI, Microsoft et Anthropic s’engagent
Un même signal dans robots.txt dira bientôt non à l'entraînement de plusieurs IA d'un coup. Comment l'écrire, ce qu'il bloque, et pourquoi attendre 2027.
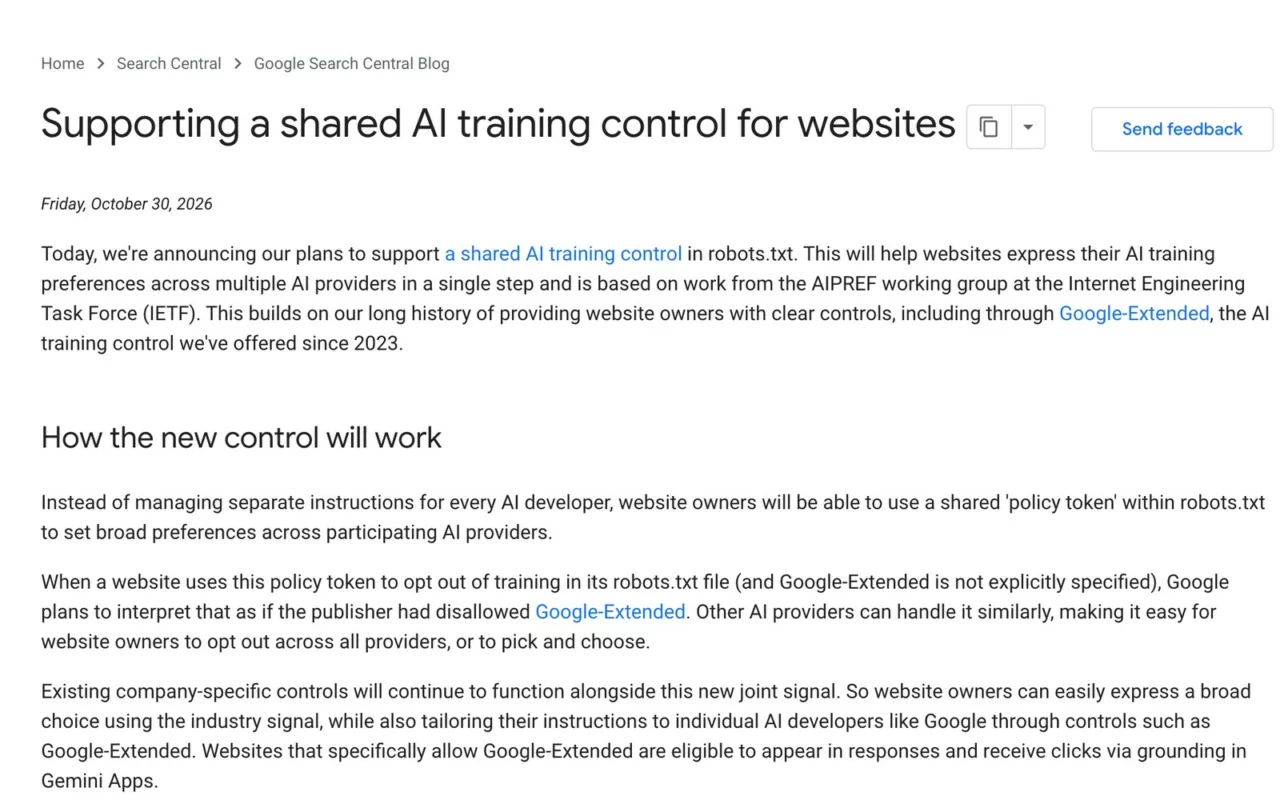
Pour dire non aux robots d’IA, un site doit pour l’instant les nommer un par un dans son fichier robots.txt : GPTBot pour OpenAI, Google-Extended pour Google, ClaudeBot pour Anthropic, et la liste s’allonge. Les bibliothèques numériques en savent quelque chose, Gallica la première (on en a parlé ICI).
Le vendredi 30 octobre 2026, Google, OpenAI, Microsoft et Anthropic ont annoncé qu’ils respecteraient un signal commun, valable pour tous d’un coup. Meta salue l’idée, sans promettre de l’appliquer, rapporte The Verge.
La ligne à écrire
Le mécanisme est décrit dans un projet de norme déposé à l’IETF, l’organisme qui normalise les protocoles d’Internet, par Kevin Kelley, d’Anthropic. Il tient en un nom de robot fictif, à placer dans le fichier robots.txt à la racine du site :
User-Agent: __usage_ai-training
Disallow: /
La première ligne vise l’usage « entraînement d’IA » ; la seconde le refuse pour tout le site. On peut ajouter des lignes Allow: pour autoriser un dossier, par exemple un kit de presse. Le nom doit être écrit exactement ainsi : les règles générales en User-Agent: * ne comptent pas pour ce signal.
Ce qu’il bloque, et ce qu’il laisse passer
Le signal ne concerne que l’entraînement des modèles d’IA générative. Il ne touche ni l’indexation par les moteurs de recherche, ni les réponses d’IA qui citent vos pages en temps réel. Chez Google, il équivaut à refuser Google-Extended, sauf si le site a réglé Google-Extended explicitement : un site qui autorise Google-Extended reste éligible aux réponses de Gemini qui renvoient des clics.
Surtout, rien ne change tout de suite. OpenAI parle d’une mise en œuvre « dans les prochains mois », Google vise 2027. Et le système reste volontaire : un robot qui ignore déjà robots.txt continuera de l’ignorer. Google souligne que l’approche est conforme au code de bonnes pratiques européen pour les modèles d’IA à usage général, qui reconnaît robots.txt comme moyen d’exprimer ses préférences.
En pratique, sur votre site
- Ajoutez les deux lignes du signal commun : elles ne coûtent rien et vaudront pour tous les signataires dès qu’ils l’appliqueront.
- Gardez vos règles par robot (GPTBot, Google-Extended, ClaudeBot) : ce sont elles qui comptent jusqu’en 2027.
- Sur WordPress, le fichier robots.txt est souvent généré par le site ; une extension de référencement ou un fichier robots.txt déposé à la racine permet de le compléter.
- Vérifiez le résultat en ouvrant votre-site.be/robots.txt dans un navigateur.
Cet article…
Le Bien Heureux · Rédaction Capibara · Dimanche 1 novembre 2026